เทคโนโลยีการสร้างคำบรรยาย

เทคโนโลยีสร้างคำบรรยายด้วย OCR และ ASR

คำบรรยายสำหรับงานผลิตไม่ใช่บทถอดเสียงที่เพียงเติมไทม์สแตมป์ภายหลัง Weydub ใช้กระบวนการทำงานอิสระสองแบบ ได้แก่ Video OCR ตามเวลาสำหรับข้อความที่ฝังอยู่ในภาพแล้ว และ ASR ที่พร้อมใช้สร้างคำบรรยายสำหรับบทสนทนาที่มีอยู่เฉพาะในเสียง

98.25%ความแม่นยำของ OCR ระดับอักขระ
98.92%การเรียกคืนคิวแบบเคร่งครัด
300K+ตอนละครสั้นที่ประมวลผลต่อวัน
การวิเคราะห์แหล่งต้นทางแบบสด OCR วิดีโอ / SRT
บทสนทนา / เก็บไว้ ข้อความปฏิเสธความรับผิดชอบ / ตัดออก การ์ดตัวละคร / ตัดออก
ผลลัพธ์ที่แก้ไขได้SRT
คิว

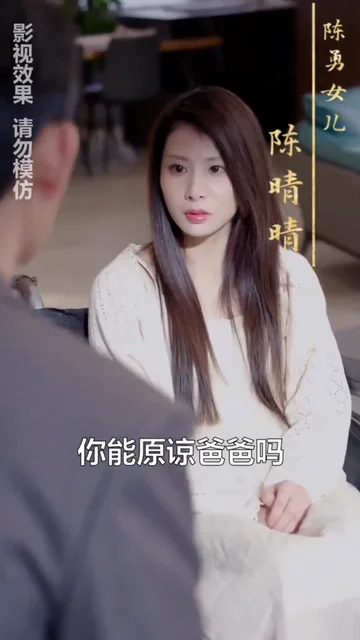
你能原谅爸爸吗

คิวบทสนทนาคงไว้
ข้อความซ้อนในฉากไม่รวม

เฟรมต้นฉบับหนึ่งเฟรมอาจมีข้อความที่อ่านได้หลายประเภท มีเพียงบทสนทนาเท่านั้นที่อยู่ในไทม์ไลน์คำบรรยาย

เดโมจากละครสั้นจริงที่เผยแพร่ต่อสาธารณะ ซึ่งใช้เพื่ออธิบายการจำแนกคำบรรยาย สิทธิ์ในเนื้อหาต้นฉบับยังคงเป็นของเจ้าของเนื้อหา

การทดสอบเปรียบเทียบละครสั้นเรื่องเดียวกัน

ความแม่นยำสำคัญที่สุดในจุดที่ผู้ปฏิบัติงานเห็นผล นั่นคือไทม์ไลน์คิว

Weydub ประเมินกระบวนการ OCR สำหรับคำบรรยายฝังในวิดีโอเทียบกับระบบ ASR พื้นฐานแบบเสียงอย่างเดียวที่ผ่านการทดสอบหนึ่งระบบ บนชุดตรวจสอบความถูกต้องของละครสั้นเรื่องเดียวกัน โดยใช้ข้อมูลอ้างอิงคำบรรยายบรรณาธิการที่มนุษย์ตรวจทานแล้วเป็นเกณฑ์อ้างอิงหลัก

สิ่งที่วัดการเปรียบเทียบเวิร์กโฟลว์โดยใช้คำบรรยายอ้างอิง ไม่ใช่ค่าเฉลี่ยจากโอเพนซอร์สหรือเกณฑ์มาตรฐาน WER ของ ASR ที่ใช้ได้ทั่วไป ระบบพื้นฐานจากเสียงใช้ ElevenLabs Scribe v2 กับเสียงร้องที่แยกออกมา

คำอธิบายเชิงเทคนิค

การสร้างคำบรรยายด้วย AI ทำงานอย่างไร: Video OCR เทียบกับ ASR

ติดตามเส้นทางสัญญาณอิสระสองสายจากวิดีโอต้นฉบับไปสู่ SRT ที่แก้ไขและกำหนดเวลาเรียบร้อยแล้ว แล้วดูว่าเหตุใดความแม่นยำระดับคิวจึงสำคัญกว่าคะแนนการรู้จำเพียงค่าเดียว

เลือกแหล่งต้นทางที่ดีกว่า

วิดีโอหนึ่งรายการอาจมีแหล่งอ้างอิงหลักที่แตกต่างกันสองแบบ

ใช้ OCR เมื่อวิดีโอมีคำบรรยายแบบฝังที่เชื่อถือได้อยู่แล้ว ใช้ ASR เมื่อบทสนทนามีอยู่ในเสียง แต่ไม่มีข้อความคำบรรยายที่ใช้การได้ปรากฏให้เห็น

ละครสั้นทำให้เห็นความแตกต่างได้ชัดเจน ดนตรี เอฟเฟกต์ สำเนียง การร้องไห้ การตะโกน การกระซิบ เสียงพูดซ้อนกัน และบทสนทนาภาษาพูด ล้วนรบกวนการรู้จำเสียงพูดได้ แทร็กคำบรรยายที่ตัดต่ออย่างมืออาชีพมักสะท้อนบทสนทนาที่ต้องการได้ชัดเจนกว่า

OCR / 01

อ่านสัญญาณเชิงบรรณาธิการจากภาพ

เหมาะที่สุดสำหรับคำบรรยายฝังในวิดีโอ คำบรรยายประกอบ และข้อความบทสนทนาที่มองเห็นได้ ความท้าทายสำคัญคือการเปลี่ยนการตรวจจับซ้ำในแต่ละเฟรมให้เป็นไทม์ไลน์เดียวที่เสถียร พร้อมคัดกรองข้อความในฉากออก

  • การประมวลผลพื้นที่และเวลาอัตโนมัติ
  • การรวมข้อมูลตามเวลาข้ามเฟรม
  • การกรองข้อความในฉากและการแก้ไขอย่างระมัดระวัง
ASR / 02

เปลี่ยนเสียงพูดเป็นคำบรรยาย ไม่ใช่ย่อหน้า

เหมาะที่สุดเมื่อซาวด์แทร็กเป็นแหล่งบทสนทนาเพียงแหล่งเดียว การรู้จำเป็นเพียงขั้นตอนแรก การแบ่งช่วงคำบรรยายให้อ่านง่าย การกำหนดเวลา ความยาวบรรทัด และการเปลี่ยนผู้พูดต่างหากที่กำหนดว่าผลลัพธ์จะใช้งานได้หรือไม่

  • การรู้จำเสียงพูดพร้อมการระบุเวลาระดับคำ
  • การแบ่งช่วงตามความหมายและสัญญาณเสียง
  • การตรวจจับผู้พูดเพิ่มเติมเมื่อระบบรองรับ

OCR วิดีโอ

OCR จากภาพมองเห็นเฟรม แต่ระบบคำบรรยายเข้าใจเวลา

ที่ 30 fps วิดีโอหนึ่งนาทีมี 1,800 เฟรม การเรียกใช้ OCR ทั่วไปแยกกันในแต่ละเฟรมทำให้ต้องทำงานซ้ำและได้กล่องข้อความซ้ำกัน ผลิตภัณฑ์คำบรรยายวิดีโอต้องเชื่อมการสังเกตเหล่านั้นเข้าด้วยกันเป็นเหตุการณ์ที่มีการกำหนดเวลา

ซับไตเติลเดียวตลอดเฟรมที่สุ่มตัวอย่าง00.50s → 00.95s
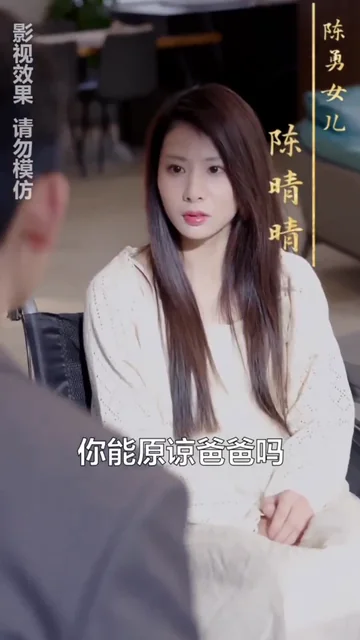
เฟรมละครสั้นที่ 15 ณ เวลา 0.50 วินาที แสดงคำบรรยายบทสนทนาเดียวกันเฟรม 01500.50s
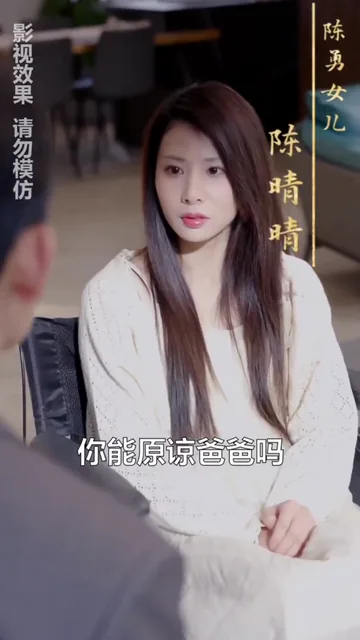
เฟรมละครสั้นที่ 20 ณ เวลา 0.65 วินาที แสดงคำบรรยายบทสนทนาเดียวกันเฟรม 02000.65s
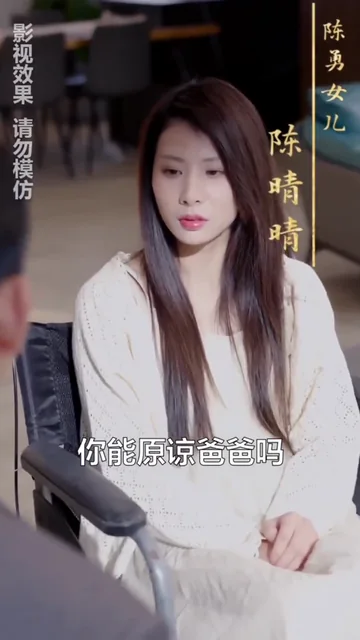
เฟรมละครสั้นที่ 24 ณ เวลา 0.80 วินาที แสดงคำบรรยายบทสนทนาเดียวกันเฟรม 02400.80s
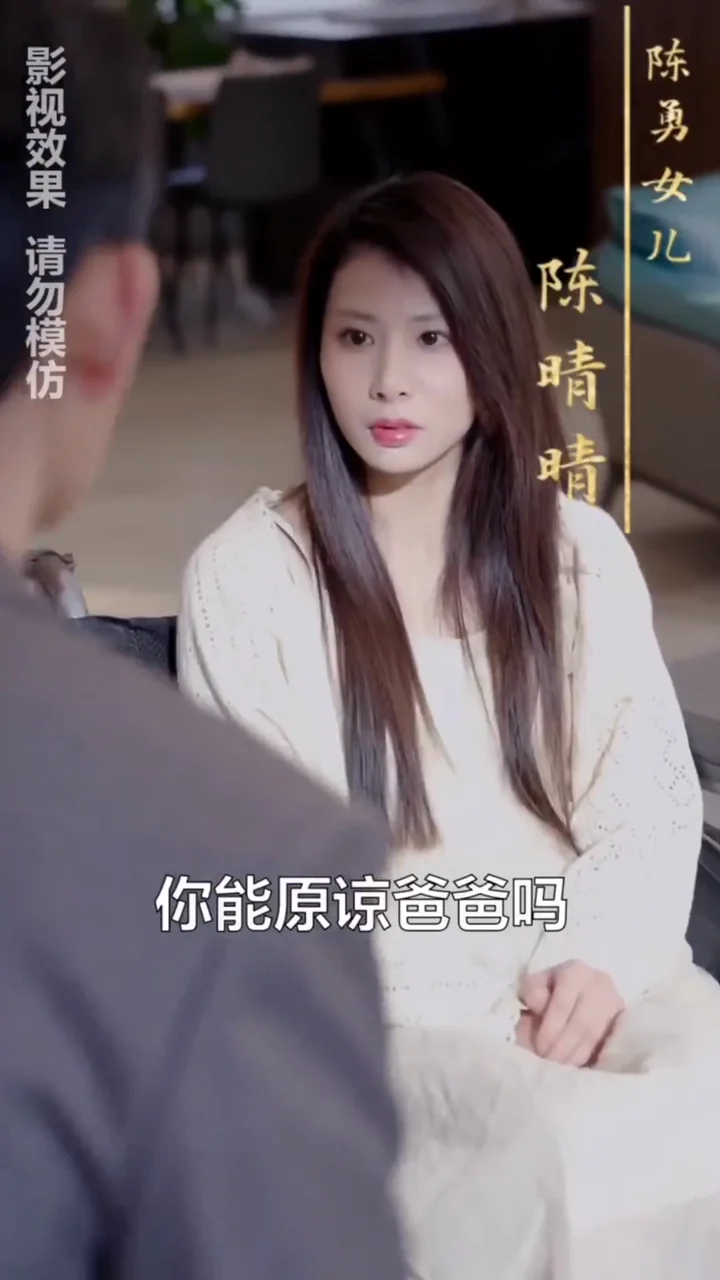
เฟรมละครสั้นที่ 29 ณ เวลา 0.95 วินาที แสดงคำบรรยายบทสนทนาเดียวกันเฟรม 02900.95s
ผลการตัดสินใจรวมหนึ่งคิว ไม่ใช่การตรวจจับซ้ำสี่ครั้ง
00:00:00,420 --> 00:00:02,260
你能原谅爸爸吗
การตรวจจับซ้ำสามารถจัดกลุ่มตามเวลาให้เป็นเหตุการณ์คำบรรยายเดียวที่เสถียรได้ ภาพนี้อธิบายปัญหาของระบบ ไม่ได้เปิดเผยวิธีการทำงานเฉพาะที่เป็นกรรมสิทธิ์ของ Weydub
01

ตรวจจับรายการที่เป็นไปได้

ใช้พื้นที่ที่เกี่ยวข้องหรือทั้งเฟรมเพื่อค้นหาข้อความที่อาจอยู่ในแทร็กบทสนทนา

02

รวมข้อมูลตามเวลา

จัดกลุ่มการตรวจจับที่อยู่ใกล้กันตามข้อความ ตำแหน่ง และการปรากฏต่อเนื่อง เพื่อประมาณเหตุการณ์ที่เสถียร

03

กรองและแก้ไข

ลดข้อความในฉากที่ปรากฏโดยบังเอิญและแก้ไขสัญญาณรบกวนจากการรู้จำที่เห็นได้ชัด โดยไม่แต่งเติมบทสนทนา

04

จัดทำไทม์ไลน์

รวมส่วนย่อย กำหนดขอบเขตเริ่มต้น/สิ้นสุด และส่งออกคิวคำบรรยาย SRT ที่แก้ไขได้

การควบคุมผลบวกลวง

การรู้จำทุกคำไม่เหมือนกับการสร้างคำบรรยาย

ในเฟรมอาจมีป้าย หน้าจอโทรศัพท์ ฉลากสินค้า โลโก้ ป้ายชื่อ คำเตือน และข้อความส่งเสริมการขายซ้อนทับ Weydub เปิดให้กรองข้อความในฉากได้ เพราะแทร็กคำบรรยายควรมีบทสนทนา ไม่ใช่ทุกพิกเซลที่อ่านได้

พื้นที่เน้นการดึงข้อมูลจากแถบคำบรรยาย
เวลาจำกัดการประมวลผลไว้เฉพาะช่วงเวลาที่เกี่ยวข้อง
ภาษาใช้ชุดอักขระและเส้นทางการรู้จำที่ถูกต้อง
ตรวจสอบแสดงเหตุการณ์ที่ไม่แน่นอนให้ผู้ปฏิบัติงานเห็น
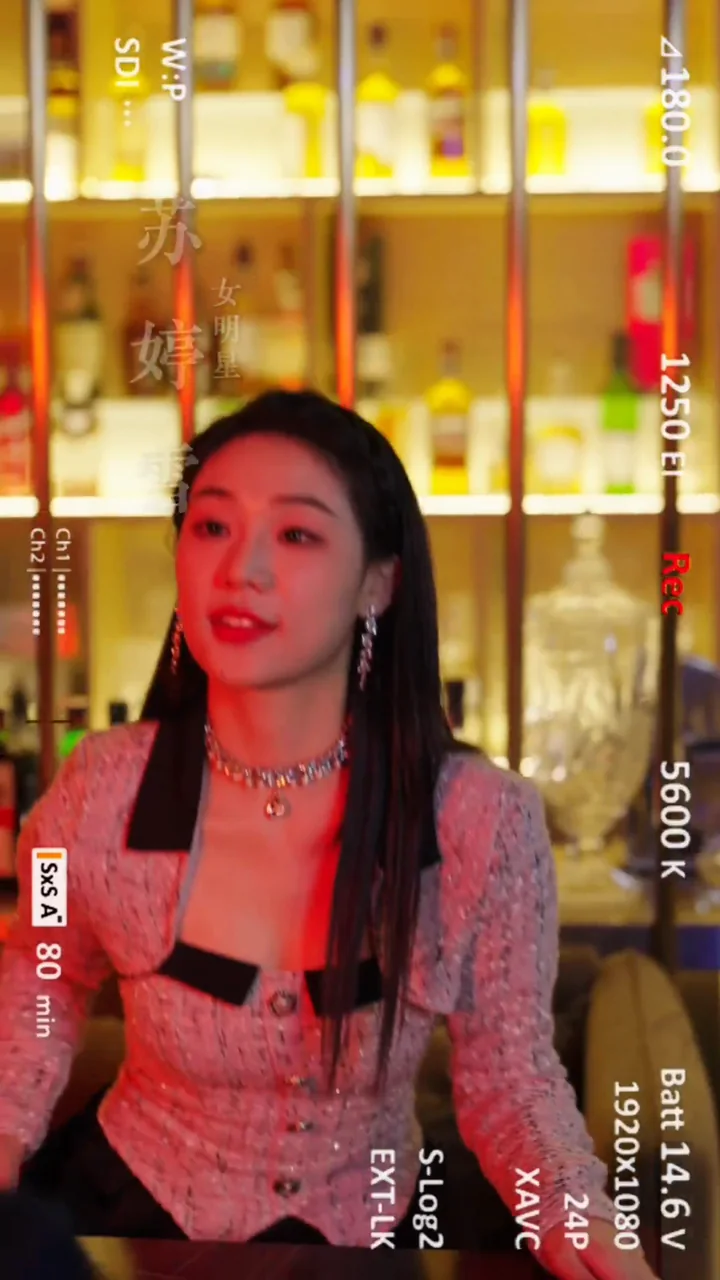
เฟรมละครสั้นที่มีคำบรรยายบทสนทนา ข้อความปฏิเสธความรับผิด และการ์ดตัวละคร
คงไว้เป็นคำบรรยายคำบรรยายบทสนทนา

ประโยคที่พูดควรอยู่ในแทร็กคำบรรยายที่กำหนดเวลาไว้

ตัดออก: ข้อความปฏิเสธความรับผิดข้อความชี้แจงด้านความปลอดภัย

ข้อความทางกฎหมายหรือข้อความจากฝ่ายผลิตที่ปรากฏต่อเนื่องไม่ใช่บทสนทนา

ตัดออก: การ์ดแนะนำตัวละครกราฟิกชื่อและบทบาท

ข้อความซ้อนทับที่ระบุตัวตนของตัวละครควรอยู่นอกไทม์ไลน์บทสนทนา

เฟรมละครสั้นที่มีอินเทอร์เฟซกล้องซึ่งมีองค์ประกอบหนาแน่นและข้อความตกแต่ง ซึ่งไม่ควรกลายเป็นคิวคำบรรยาย
ตัดออก: UI กล้องข้อความบนอินเทอร์เฟซทางเทคนิค

พารามิเตอร์ มาตราส่วน และข้อความซ้อนทับจากอุปกรณ์ยังคงเป็นส่วนหนึ่งของภาพ

ข้อความที่อ่านได้ไม่ได้หมายความว่าเป็นบทสนทนา

OCR วิดีโอต้องจำแนกข้อความก่อนจึงจะสร้างไฟล์คำบรรยายที่ใช้งานได้

เฟรมจริงจากเดโมสาธารณะช่วยแสดงให้เห็นปัญหาการจำแนกประเภท สิทธิ์ในเนื้อหาต้นฉบับยังคงเป็นของเจ้าของเนื้อหา

ASR ที่พร้อมใช้สร้างคำบรรยาย

ทรานสคริปต์ที่ถูกต้องยังอาจเป็นไฟล์คำบรรยายคุณภาพต่ำ

ASR แบบดั้งเดิมรู้จำเสียงพูด การสร้างคำบรรยายยังต้องกำหนดช่วงคำบรรยาย โดยแบ่งสตรีมคำให้เป็นคิวที่กระชับ อ่านง่าย และกำหนดเวลาไว้ โดยสอดคล้องกับความหมายของประโยค ช่วงหยุด การผลัดกันพูดของผู้พูด และข้อจำกัดด้านการแสดงผล

บริบทโอเพนซอร์ส

ไม่มีค่าเฉลี่ยสากลที่มีความหมายสำหรับการเปรียบเทียบ OCR กับ ASR

โครงการสาธารณะวัดตัวชี้วัดที่แตกต่างกันบนชุดข้อมูลที่แตกต่างกัน มีประโยชน์ในการแสดงให้เห็นว่าความแม่นยำเปลี่ยนแปลงมากเพียงใดตามชุดอักขระ ภาษา สัญญาณรบกวน และเงื่อนไขการบันทึก แต่ไม่ใช่ลีดเดอร์บอร์ดเดียวสำหรับความพร้อมด้านคำบรรยายวิดีโอ

PP-OCRv5ความแม่นยำในการรู้จำ 80.27% ถึง 94.20%

ความแม่นยำในการรู้จำจากชุดข้อมูลหลายภาษาที่เผยแพร่และจำแนกตามชุดอักขระ ตัวเลขนี้วัดการรู้จำข้อความ ไม่ใช่ขั้นตอนการทำงานด้านคำบรรยายวิดีโอแบบครบวงจรตามเวลา

อ่านผลการทดสอบ PaddleOCR
Whisper large-v2WER เฉลี่ย 12.8% จากชุดข้อมูลภาษาอังกฤษ 14 ชุด

บทความเดียวกันรายงาน 2.7% จาก LibriSpeech clean, 25.5% จากเสียงพูดที่มีสัญญาณรบกวนของ CHiME-6 และ 36.4% จากเสียงพูดระยะไกลของ AMI เงื่อนไขการบันทึกทำให้ผลลัพธ์เปลี่ยนแปลงอย่างมาก

อ่านบทความ Whisper
ข้อสรุปสำหรับการผลิตไม่ใช่ว่าวิธีใดวิธีหนึ่งจะชนะเสมอ แต่คือ: ใช้สัญญาณต้นทางที่สะอาดที่สุดเท่าที่มี ในละครสั้นที่มีคำบรรยายฝังในวิดีโอที่แม่นยำและเสียงผสมที่มีสัญญาณรบกวน แทร็กภาพมักเป็นแหล่งข้อมูลที่ดีกว่า
การดำเนินงาน ไม่ใช่ตัวชี้วัดเชิงภาพลักษณ์

ความแม่นยำที่ต่างกันเพียงไม่กี่จุดอาจกลายเป็นการตรวจทานหลายสัปดาห์

ตลอดซีรีส์ที่ดำเนินต่อเนื่องเป็นเวลานาน ความหนาแน่นของข้อผิดพลาดต่ำทำให้ตรวจทานเฉพาะจุดได้อย่างมีเป้าหมาย ส่วนความหนาแน่นของข้อผิดพลาดสูงบังคับให้ผู้ปฏิบัติงานตรวจทานทีละบรรทัด ทำให้การแก้ไขคำบรรยายกลายเป็นคอขวดในการผลิต

การแก้ไขแต่ละครั้งต้องมีคนค้นหาคิว เปิดดูบริบทซ้ำ ตรวจสอบถ้อยคำที่ต้องการ แก้ไข และตรวจสอบอีกครั้ง เมื่อข้อผิดพลาดเกิดขึ้นหนาแน่น ผู้ปฏิบัติงานจะเลิกไว้วางใจผลลัพธ์และตรวจทานทุกบรรทัด

ข้อผิดพลาดน้อยการตรวจทานเฉพาะจุดคิวการแก้ไขที่จัดการได้
ข้อผิดพลาดมากการตรวจทานทีละบรรทัดคอขวดในการผลิต
ภาระงานแก้ไขในระดับซีรีส์

คุณภาพการปรับให้เข้ากับท้องถิ่น

คุณภาพคำบรรยายต้นทางเป็นตัวกำหนดเพดานคุณภาพของขั้นตอนถัดไป

ข้อผิดพลาดด้านการแปลหรือการพากย์เสียงที่ดูเหมือนเกิดขึ้นภายหลังจำนวนมากเริ่มต้นตั้งแต่ขั้นตอนก่อนหน้า คำต้นทางที่ผิด ขอบเขตคิวที่ไม่ดี หรือการเปลี่ยนผู้พูดที่ไม่ถูกต้องจะถูกส่งต่อไปยังโมเดลทุกตัวในขั้นตอนถัดไป ดูว่าไทม์ไลน์ต้นทางที่เชื่อถือได้ส่งต่อไปยัง การแปลคำบรรยายระดับซีรีส์ที่คำนึงถึงบริบท และจากนั้นยังรองรับ การพากย์เสียงด้วย AI ที่คำนึงถึงตัวละครและการจัดแนวภาพและเสียง.

การส่งมอบงานผลิต

จากวิดีโอหนึ่งรายการสู่ขั้นตอนการทำงานของ Studio และ API ที่ทำซ้ำได้

คุณภาพการรู้จำสำคัญ แต่การผลิตยังต้องมีชุดงาน การติดตามสถานะ ผลลัพธ์ที่แก้ไขได้ การส่งผลกลับผ่าน callback และการส่งต่องานที่ราบรื่นไปยังการแปลและการพากย์เสียงด้วย AI

STUDIO

จัดระเบียบโปรเจกต์และชุดงาน

อัปโหลดหลายตอน เลือก OCR หรือ ASR สำหรับแต่ละแหล่งข้อมูล และเก็บงานซีรีส์ที่ทำซ้ำได้ไว้ในพื้นที่ทำงานการผลิตเดียว

สำรวจขั้นตอนการทำงานของ Studio
WORKS

ติดตามสถานะและรวบรวมผลลัพธ์

ตรวจสอบสถานะงาน เปิดผลลัพธ์ที่เสร็จแล้ว ดาวน์โหลด SRT ที่แก้ไขได้ และดำเนินการต่อไปยังการแปลหรือการพากย์เสียง

อ่านคู่มือการสร้าง
API

ทำให้งานแบบอะซิงโครนัสเป็นอัตโนมัติ

ส่งงาน OCR หรือ ASR เก็บ ID ของโปรเจกต์และงาน จากนั้นใช้การ polling หรือการส่งผ่าน callback ในไปป์ไลน์สื่อของคุณเอง

อ่านเอกสารอ้างอิง API

คำตอบที่ชัดเจน

FAQ การสร้างคำบรรยายด้วย AI

คำนิยามสำหรับผู้ปฏิบัติงาน นักพัฒนา เครื่องมือค้นหา และระบบ AI ที่ต้องการคำอธิบายขั้นตอนการทำงานอย่างแม่นยำ

การสร้างคำบรรยายด้วย AI คืออะไร

การสร้างคำบรรยายด้วย AI จะแปลงข้อความที่มองเห็นหรือบทสนทนาที่พูดเป็นคิวคำบรรยายพร้อมเวลา ผลลัพธ์สำหรับการผลิตประกอบด้วยข้อความ เวลาเริ่มต้นและสิ้นสุด การแบ่งคิวให้อ่านง่าย ข้อมูลภาษา และรูปแบบที่แก้ไขได้ เช่น SRT

OCR สามารถดึงคำบรรยายที่ฝังอยู่ในวิดีโอออกมาได้หรือไม่

ได้ OCR ในวิดีโอสามารถตรวจจับข้อความที่ฝังอยู่ในเฟรม จัดกลุ่มการตรวจจับซ้ำตามช่วงเวลา ประเมินขอบเขตคิว กรองข้อความในฉากที่ไม่เกี่ยวข้อง และส่งออกคิวคำบรรยายพร้อมเวลาได้

ทำไมจึงใช้ OCR แทน ASR สำหรับละครสั้น

เมื่อคำบรรยายที่ฝังอยู่มีความถูกต้อง OCR จะอ่านสัญญาณข้อความจากงานตัดต่อ ซึ่งได้รับผลกระทบจากดนตรี เอฟเฟกต์ สำเนียง การร้องไห้ การตะโกน การกระซิบ และบทสนทนาที่พูดทับซ้อนกันน้อยกว่า

เหตุใดทรานสคริปต์ที่ถูกต้องจึงยังเป็นคำบรรยายที่ไม่มีคุณภาพได้

ทรานสคริปต์อาจเป็นย่อหน้ายาวเพียงย่อหน้าเดียว หรือมีขอบเขตที่ไม่เหมาะกับความเร็วในการอ่าน ASR ที่พร้อมสำหรับคำบรรยายต้องสร้างคิวที่กระชับและมีการกำหนดเวลา โดยแบ่งตามความหมายและการเปลี่ยนผู้พูดอย่างเหมาะสม

Weydub รวม OCR และ ASR โดยอัตโนมัติหรือไม่

ไม่ OCR และ ASR เป็นโหมดการสร้างที่แยกจากกัน ทีมสามารถเปรียบเทียบผลลัพธ์ระหว่างการตรวจทานได้ แต่ Weydub ไม่ได้อธิบายทุกงานว่าเป็นขั้นตอนการทำงาน OCR/ASR ที่ผสานรวมโดยอัตโนมัติ

สร้างไทม์ไลน์ต้นฉบับให้ดียิ่งขึ้น

สร้างไฟล์คำบรรยายที่เวิร์กโฟลว์การปรับให้เข้ากับท้องถิ่นของคุณวางใจได้

เลือก OCR สำหรับข้อความที่ฝังอยู่ หรือ ASR สำหรับเสียงพูด ตรวจทาน SRT ที่มีการกำหนดเวลา แล้วดำเนินการต่อไปยังการแปล การพากย์เสียงด้วย AI และการส่งออก

เริ่มต้นใช้งาน Weydub